10 min de leitura
#7 - Regressão Polinomial e Múltipla
Como usar regressão polinomial quando os dados não seguem uma linha reta, e regressão múltipla quando a previsão depende de mais de uma variável - com R² e coeficientes explicados.
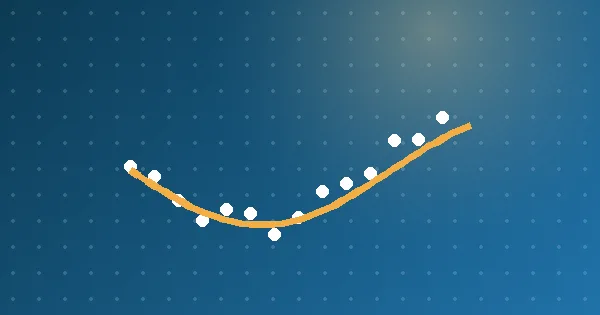
A regressão linear do post anterior só funciona quando os pontos seguem, de fato, uma linha reta. Quando isso não acontece, mas ainda existe algum padrão nos dados, entra a regressão polinomial. E quando um único valor não é suficiente pra prever o resultado, entra a regressão múltipla, que combina duas ou mais variáveis independentes.
Regressão Polinomial
Desta vez, o dataset registra 18 carros passando por um pedágio: x é a hora do dia, y é a velocidade registrada.
import matplotlib.pyplot as plt

x = [1, 2, 3, 5, 6, 7, 8, 9, 10, 12, 13, 14, 15, 16, 18, 19, 21, 22]
y = [100, 90, 80, 60, 60, 55, 60, 65, 70, 70, 75, 76, 78, 79, 90, 99, 99, 100]

plt.scatter(x, y)
plt.show()
Olhando pro gráfico, os pontos formam uma curva — não uma reta: a velocidade cai de manhã, chega num vale, e volta a subir no fim do dia. NumPy tem um método pronto pra ajustar um modelo polinomial a esses dados.
import numpy
import matplotlib.pyplot as plt

x = [1, 2, 3, 5, 6, 7, 8, 9, 10, 12, 13, 14, 15, 16, 18, 19, 21, 22]
y = [100, 90, 80, 60, 60, 55, 60, 65, 70, 70, 75, 76, 78, 79, 90, 99, 99, 100]

meu_modelo = numpy.poly1d(numpy.polyfit(x, y, 3))

minha_linha = numpy.linspace(1, 22, 100)

plt.scatter(x, y)
plt.plot(minha_linha, meu_modelo(minha_linha))
plt.show()
numpy.polyfit(x, y, 3) ajusta um polinômio de grau 3 aos dados, e numpy.poly1d() transforma isso num modelo utilizável. minha_linha gera 100 pontos entre 1 e 22, usados só pra desenhar a curva de forma suave.
R-quadrado
Assim como o r da regressão linear, existe uma medida de quão boa é a relação entre x e y na regressão polinomial: o r-quadrado (R²), que varia de 0 (nenhuma relação) a 1 (relação perfeita).
import numpy
from sklearn.metrics import r2_score

x = [1, 2, 3, 5, 6, 7, 8, 9, 10, 12, 13, 14, 15, 16, 18, 19, 21, 22]
y = [100, 90, 80, 60, 60, 55, 60, 65, 70, 70, 75, 76, 78, 79, 90, 99, 99, 100]

meu_modelo = numpy.poly1d(numpy.polyfit(x, y, 3))

print(r2_score(y, meu_modelo(x)))
A saída é:
0.9432150416451025
Um R² de 0.94 indica uma relação bem forte — dá pra usar esse modelo em previsões com confiança.
Prevendo valores futuros
Qual seria a velocidade de um carro passando pelo pedágio por volta das 17h?
import numpy
from sklearn.metrics import r2_score

x = [1, 2, 3, 5, 6, 7, 8, 9, 10, 12, 13, 14, 15, 16, 18, 19, 21, 22]
y = [100, 90, 80, 60, 60, 55, 60, 65, 70, 70, 75, 76, 78, 79, 90, 99, 99, 100]

meu_modelo = numpy.poly1d(numpy.polyfit(x, y, 3))

velocidade = meu_modelo(17)
print(velocidade)
A saída é:
88.87331269697987
Nota: assim como na regressão linear, sempre confira o R² antes de confiar num modelo polinomial. Com o mesmo dataset “ruim” usado no post anterior (sem relação real entre
xey), o R² despenca pra0.00995— um sinal claro de que a regressão polinomial não é adequada pra esse conjunto de dados.
Regressão Múltipla
A regressão múltipla é como a linear, mas em vez de prever com base numa única variável, usa duas ou mais. Por exemplo: dá pra prever a emissão de CO2 de um carro só pelo tamanho do motor, mas a previsão fica mais precisa se você também levar em conta o peso do carro.
O dataset usado a partir daqui (salvo como data.csv) tem estas colunas — carro, modelo, volume do motor (cm³), peso (kg) e emissão de CO2:
| Car | Model | Volume | Weight | CO2 |
|---|---|---|---|---|
| Toyota | Aygo | 1000 | 790 | 99 |
| Mitsubishi | Space Star | 1200 | 1160 | 95 |
| Skoda | Citigo | 1000 | 929 | 95 |
| Fiat | 500 | 900 | 865 | 90 |
| Mini | Cooper | 1500 | 1140 | 105 |
| VW | Up! | 1000 | 929 | 105 |
| Skoda | Fabia | 1400 | 1109 | 90 |
| Mercedes | A-Class | 1500 | 1365 | 92 |
| Ford | Fiesta | 1500 | 1112 | 98 |
| Audi | A1 | 1600 | 1150 | 99 |
| Hyundai | I20 | 1100 | 980 | 99 |
| Suzuki | Swift | 1300 | 990 | 101 |
| Ford | Fiesta | 1000 | 1112 | 99 |
| Honda | Civic | 1600 | 1252 | 94 |
| Hyundai | I30 | 1600 | 1326 | 97 |
| Opel | Astra | 1600 | 1330 | 97 |
| BMW | 1 | 1600 | 1365 | 99 |
| Mazda | 3 | 2200 | 1280 | 104 |
| Skoda | Rapid | 1600 | 1119 | 104 |
| Ford | Focus | 2000 | 1328 | 105 |
| Ford | Mondeo | 1600 | 1584 | 94 |
| Opel | Insignia | 2000 | 1428 | 99 |
| Mercedes | C-Class | 2100 | 1365 | 99 |
| Skoda | Octavia | 1600 | 1415 | 99 |
| Volvo | S60 | 2000 | 1415 | 99 |
| Mercedes | CLA | 1500 | 1465 | 102 |
| Audi | A4 | 2000 | 1490 | 104 |
| Audi | A6 | 2000 | 1725 | 114 |
| Volvo | V70 | 1600 | 1523 | 109 |
| BMW | 5 | 2000 | 1705 | 114 |
| Mercedes | E-Class | 2100 | 1605 | 115 |
| Volvo | XC70 | 2000 | 1746 | 117 |
| Ford | B-Max | 1600 | 1235 | 104 |
| BMW | 2 | 1600 | 1390 | 108 |
| Opel | Zafira | 1600 | 1405 | 109 |
| Mercedes | SLK | 2500 | 1395 | 120 |
Com o Pandas, dá pra separar as colunas que servem de entrada (X) da coluna que se quer prever (y), e ajustar um modelo de regressão linear com as duas variáveis de entrada.
import pandas
from sklearn import linear_model

df = pandas.read_csv("data.csv")

X = df[['Weight', 'Volume']]
y = df['CO2']

regr = linear_model.LinearRegression()
regr.fit(X, y)

# prever a emissão de CO2 de um carro com peso 2300kg e motor de 1300cm³
co2_previsto = regr.predict([[2300, 1300]])

print(co2_previsto)
A saída é:
[107.2087328]
O modelo prevê que um carro com motor de 1.3 litro e 2300kg vai emitir aproximadamente 107 gramas de CO2 por quilômetro rodado.
Coeficiente
O coeficiente descreve a relação com uma variável desconhecida — se x é uma variável, 2x é o dobro de x; x é a variável, 2 é o coeficiente. Aqui, dá pra pedir o coeficiente de peso e de volume em relação ao CO2, pra saber o que aconteceria se um desses valores aumentasse ou diminuísse.
import pandas
from sklearn import linear_model

df = pandas.read_csv("data.csv")

X = df[['Weight', 'Volume']]
y = df['CO2']

regr = linear_model.LinearRegression()
regr.fit(X, y)

print(regr.coef_)
A saída é:
[0.00755095 0.00780526]
Isso significa: se o peso aumentar 1kg, a emissão de CO2 aumenta 0.00755095g; se o volume do motor aumentar 1cm³, a emissão aumenta 0.00780526g. Vamos testar: e se o peso do carro de antes (2300kg, motor 1300cm³) aumentasse em 1000kg?
import pandas
from sklearn import linear_model

df = pandas.read_csv("data.csv")

X = df[['Weight', 'Volume']]
y = df['CO2']

regr = linear_model.LinearRegression()
regr.fit(X, y)

co2_previsto = regr.predict([[3300, 1300]])

print(co2_previsto)
A saída é:
[114.75968007]
O modelo prevê aproximadamente 115g de CO2 por km pra esse carro mais pesado — e o cálculo bate exatamente com o coeficiente encontrado: 107.2087328 + (1000 * 0.00755095) = 114.75968.
Com regressão linear, polinomial e múltipla cobertas, o próximo post trata de um problema prático que aparece o tempo todo antes de qualquer regressão múltipla: como comparar colunas que estão em escalas completamente diferentes, e como saber se o seu modelo realmente aprendeu alguma coisa, em vez de só decorar os dados de treino.
Fonte adaptada: Polynomial Regression, Multiple Regression


Comentários